yamamototis1105’s tech blog

ネットワークを中心とした技術ブログです

Direct Connectに帯域制御が来た!VIF Rate Limiter実測検証とハイブリッドネットワークのこれから

1. はじめに

AWSハイブリッドネットワークでは、Direct ConnectやSite-to-Site VPNを初めとして、ルーティングや暗号化などの様々なサービスが拡充されてきました。一方で、帯域制御についてはAWSネイティブだけでは完結せず、ネットワーク機器や仮想アプライアンスなどで補完する場面がありました。そんな中、VIF Rate LimiterがDirect Connectの仮想インタフェース (以降、VIF) 単位で帯域上限を設定できる機能として登場し、ハイブリッドネットワークの設計に新たな選択肢が加わりました。

そこで、Direct Connectを用いたAWSハイブリッドネットワークの検証環境を構築し、VIF Rate Limiterの機能・非機能を検証しました。想定外事象が起きた際は、AWSサポートに支援いただきながら仮説と検証を繰り返しました。本記事では、検証結果から分かったことを中心に、VIF Rate Limiterの概要からユースケースや今後の期待まで幅広くご紹介します。本記事は、2026年11月1日時点の情報に基づいており、最新情報はAWS公式ドキュメントをご確認ください。

2. AWSハイブリッドネットワークの背景・課題

2.1 サービス進化で解決された暗号化の課題

サービス進化により課題を解決した一例として暗号化があります。金融機関等では、閉域ネットワークでもキャリア区間を含めた経路暗号化が求められるケースが多々あります。

Direct Connect経由した通信を暗号化する方法として、かつてはPublic VIFを用いたSite-to-Site VPNがありました。ただし、セキュリティポリシー上、パブリックIPアドレスが利用できないお客様にとっては採用しにくい構成でした。

こうした中、2021年にはDirect ConnectのMACsecが登場し、専用接続上での経路暗号化が実施できるようになりました。ただし、MACsecは接続速度や接続機器の制約があり、こちらもまた制約を受けるお客様にとっては採用しにくい構成でした。

さらに、2022年にはPrivate VIFを用いたSite-to-Site VPNを構成できるようになりました。これによりパブリックIPアドレスを利用することなく、Direct Connectの接続速度や接続機器によらず、暗号化を実現できる選択肢が加わりました。


Private IP VPNによる経路暗号化

以上のように、暗号化はAWSサービス進化により従来の課題をAWSネイティブで解決できるケースが広がってきました。

2.2 今まで残されてきた帯域制御の課題

帯域制御はいかがでしょうか。こちらも、優先・非優先トラフィックが同じネットワーク上で混在するなど、帯域干渉を避けるために帯域制御が求められるケースが多々あります。

帯域干渉を回避するためには、帯域制御を実施せずに、通信種別ごとに物理接続を分離する方法もあります。ただし、接続数の増加に伴うコスト、構成の複雑化に伴う稼動増が課題となり、現実的な選択肢ではいえませんでした。

また、アプリケーションで送信レートを制限する方法もあります。ただし、制限機能に対応していないアプリケーションもあり、仮に対応している場合でも個別に設定・管理する必要があり、ネットワーク全体での一元的な制御・管理が困難でした。

そのため、仮想ルータや仮想ファイアウォールなどのアプライアンス製品を配置し、QoS機能を用いる方法が考えられます。ただし、アプライアンス製品のライセンス費用や構築費・運用費が別途発生するほか、構成の複雑化も課題でした。


仮想アプライアンスによる帯域制御

以上のように、帯域制御は今まで残されてきた課題でしたが、新たな選択肢として登場したのがDirect ConnectのVIF Rate Limiterです。

3. VIF Rate Limiterとは

VIF Rate Limiterは、専用接続型のDirect Connect上でVIF単位の帯域上限を設定し、超過トラフィックをドロップする機能です。本機能は、あくまでも帯域上限を設定する機能であり、最低帯域を保証する機能ではありません。

例えば、1Gbpsの専用接続上に帯域上限が500MbpsのVIFがある場合、800Mbpsを送信しても500Mbpsに制御されるイメージです。このように帯域上限を設定することで、通信影響を抑制するためのガードレールとして利用できます。

主な仕様・特徴は以下の通りです。

項目 仕様・特徴
対象接続 専用接続型のDirect Connect
対象VIF Private VIF / Public VIF / Transit VIF
方向 Ingress (オンプレミス→AWS) / Egress (AWS→オンプレミス)
帯域 5 / 10 / 20 / 30 /40 / 50 / 60 / 70 / 80/ 90 / 100%
サービスクオータ   1接続あたり10設定まで (上限引き上げ可能)                
コスト 本機能の利用による追加料金なし


方向については、帯域制御はEgressに適用するイメージがありますが、本機能はIngress / Egressともに適用します。なお、IngressはDirect Connectの物理接続を通過したあとに帯域制御が行われるため、物理接続で発生する輻輳は防ぐことができないので注意してください。

帯域については、AWSマネジメントコンソールから設定可能です。具体的には、Direct Connectの仮想インターフェイス画面でVIFを作成もしくは編集するタイミングでレートを指定できます。下図の赤枠がレートを指定する箇所です。

4. VIF Rate Limiter検証で分かったこと

専用接続型のDirect Connect上にPrivate VIFを2つ構成し、オンプレミスとAWS間でiperf3を用いたUDP通信による検証を行いました。Direct Connect接続 (以降、DXCON) は1Gbpsですが、キャリアにより100Mbpsに制限されています。

検証観点は以下の通りです。

検証観点 説明
帯域制御 設定帯域に合わせて、実効帯域が変化するか
設定変更時の通信影響 通信中に設定帯域を変更した場合に通信影響が発生するか
Noisy Neighbor(帯域干渉)   同じDXCON上のVIF間で帯域干渉を抑制できるか       
CloudWatchメトリクス 帯域制御に関するメトリクスが取得できるか

4.1 基本動作

最初に、VIF Rate Limiterの設定帯域に合わせて、実効帯域が変化することを確認しました。設定帯域、送信帯域、送信方向の検証条件は以下の通りです。

検証条件 設定内容
設定帯域           Unlimited / 50 / 100 / 200Mbps                  
送信帯域 80Mbps
送信方向 Egress、Ingress、両方向同時


検証の結果、設定帯域がUnlimited / 200Mbpsの場合は想定通り、50 / 100Mbpsの場合が想定外でした。50M / 100Mbpsの設定帯域に対し、それぞれ約50 / 80Mbpsの実効帯域を想定していましたが、実際には約25 / 50Mbpsの実効帯域になりました。本事象はEgressだけでなく、Ingressや両方向同時通信でも確認されました。

なぜ実効帯域が設定帯域の約50%になるかについては、AWSサポートへ確認していました。その結果、内部マルチパスの挙動により、ストリームが同じ内部パスに集中すると実効帯域は設定帯域の約50%、ストリームが異なる内部パスに分散すると実効帯域は設定帯域通りになるとのことでした。

AWSサポート回答をイメージしやすくするため、以下に概念図を作成しました。例えば、設定帯域が50Mbpsの場合、単一ストリームでは単一パス経由で実効帯域が25Mbps、複数ストリームでは単一パス経由で25Mbpsか、複数パス経由で50Mbpsとなります。


AWSサポート回答を踏まえて、トラフィックのストリーム数を変更しながら検証しました。設定帯域、送信帯域、送信方向の検証条件は以下の通りです。

検証条件 設定内容
設定帯域           50Mbps                           
送信帯域 80Mbps × 1~4ストリーム
送信方向 Egress片方向


検証の結果、ストリーム数を増やすほど実効帯域が設定帯域通りになることを確認しました。ただし、試行回数 (各10回) は十分と言えないため、割合は正確なものではなく、あくまでも傾向として参考にしてください。

また、合計実効帯域は同じですが、各ストリームの実効帯域の組み合わせが異なるパターンがあることも確認しました。例えば、合計実効帯域が約50Mbpsの場合、ストリームが1対3および2対2で内部パスへ分散していると推定されるパターンがありました。

一連の検証から、内部パスへの割り当て次第で実効帯域が設定帯域の約50~100%で変動しうることが分かりました。現時点では、実効帯域が設定帯域を下回っても業務影響が問題ないことを確認のうえ、VIF Rate Limiterの帯域割り当てを決定する必要があります。

4.2 設定変更影響

次に、通信中にVIF Rate Limiterの設定帯域を変更した場合における影響確認を行いました。設定帯域、送信帯域、送信方向の検証条件は以下の通りです。

検証条件 設定内容
設定帯域           50Mbps → Unlimited                      
送信帯域 40Mbps × 2ストリーム
送信方向 Egress片方向


検証の結果、既存の通信フローに対しても設定変更が反映されることを確認しました。また、設定変更を実行してから反映されるまでは3分弱かかっており、反映されるタイミングで実効帯域が下がるなどの影響は確認できませんでした。

以上の検証から、通信を継続したまま設定を変更できることが分かりました。ただ、反映時間については2~4分程が多く感じられたが、最小で数十秒、最大で十分以上かかることもあったため、余裕のあるスケジューリングをお勧めします。

4.3 Noisy Neighbor抑制

続いて、同じDXCON上のVIF間で発生する帯域干渉 (Noisy Neighbor) を抑制できるかを確認しました。設定帯域、送信帯域、送信方向の検証条件は以下の通りです。

検証条件 設定内容
設定帯域           Unlimited (VIF#1) / 50Mbps (VIF#2)
送信帯域 20Mbps × 1ストリーム (VIF#1) / 80Mbps × 4ストリーム (VIF#2)  
送信方向 Egress片方向


検証の結果、片方のVIFでは設定帯域に合わせて帯域制御される一方で、もう片方のVIFでは帯域制御による通信影響を受けないことを確認しました。通信開始時・終了時とも、各VIFの実効帯域は安定して維持されていました。

以上の検証から、VIF毎に帯域制御を行うことで、VIF間の帯域干渉を抑えられることが分かりました。利用者や用途ごとにVIFを割り当て、それぞれに帯域上限を設定することで、一元的な帯域管理が実現できると考えられます。

4.4 CloudWatchメトリクス取得

最後に、帯域制御に関するメトリクスが取得できるかを確認しました。設定帯域、送信帯域、送信方向の検証条件は以下の通りです。

検証条件 設定内容
設定帯域           50Mbps                           
送信帯域 40Mbps × 2ストリーム
送信方向 Egress / Ingress片方向ずつ


検証の結果、EgressはVirtualInterfaceBpsが約50Mbps (実効帯域)、VirtualInterfaceUtilizationが約100% (実効帯域 / 設定帯域) であることを確認しました。一方、IngressはVirtualInterfaceBpsは約80Mbps (送信帯域)、VirtualInterfaceUtilizationは約160% (送信帯域 / 設定帯域) であることを確認しました。AWSサポートも本動作がサービス仕様であり、今後ドキュメントへ反映する予定との回答がありました。

また、Egress / IngressともVirtualInterfacePolicedBpsおよびVirtualInterfacePolicedPps (ポリシングされたレート) が実際のポリシング量と異なることを確認しました。さらに、ポリシングされてないタイミングでも値が増えるなど、メトリクスが正しく取得できていない状態が見られました。AWSサポートも現状正しく取得できていないことを確認し、今後原因特定および対処を行う予定との回答がありました。

以上の検証から、メトリクスによってEgress / Ingressで帯域制御前後の異なるデータを取得すること、実際のデータと乖離が生じることが分かりました。そのため、現時点では各メトリクスの特性や制約を理解したうえで、監視目的に応じた指標を選定する必要があると考えられます。

5. VIF Rate Limiterで広がるユースケース

ここまでの検証から、VIF Rate Limiterでは実効帯域やメトリクスで注意すべきポイントがありますが、帯域制御やNoisy Neighbor抑制における有用性が確認できました。特に、利用者や用途が異なる通信を同じDirect Connect接続上で共有する環境での活用が期待できます。

5.1 マルチテナント基盤

同一Direct Connect専用接続上にて、複数の顧客や部門が接続を共有する構成を考えられます。顧客や部門ごとにVIFを割り当て、帯域上限を設定することで、特定利用者のトラフィックが急増した場合にも、他の利用者へ与える影響を抑えることが可能です。

5.2 マルチサービス基盤

同一Direct Connect専用接続上にて、オンライン系・情報系・運用系などの異なるサービスが通信する構成が考えられます。帯域上限が設定された情報系・運用系で大容量通信が発生しても、重要度の高いオンラインへの影響を抑えることが可能です。

6. VIF Rate Limiterへの今後の期待

VIF Rate Limiterがリリースされたことで、VIF単位での帯域制御がAWSネイティブで実現できるようになりました。今後、オンプレミスルータで利用できる階層型QoSのように、1層目で利用者ごとに帯域制御を行い、2層目で通信クラスごとに優先制御を行えるようになることを期待します。例えば、特定利用者を帯域制御し、さらにサービス通信ごとに帯域案分することが可能となります。このような機能により、ハイブリッドネットワークにおけるQoS設計の自由度はさらに高まると思います。

7. まとめ

AWSハイブリッドネットワークに帯域制御という新たな設計を切り開いたVIF Rate Limiterについて、ご紹介しました。

  • 専用接続型のDirect Connect上でVIFの帯域制御を行い、超過トラフィックをドロップするシンプルな機能であること

  • 実効帯域が内部マルチパスの挙動で変動しうること、 設定変更時の通信影響は発生しないこと、Noisy Neighborは抑制されること、CloudWatchメトリクスが今後の改善へ期待したいこと

  • マルチテナント・マルチサービス基盤へ適用したユースケースや、より高度なQoS設計を実現する今後への期待

AWSハイブリッドネットワークの帯域設計や共用基盤で同様の課題を持つ方にとって、本記事が参考になれば幸いです。

AWS Direct Connectメンテナンスに伴う通信断回避のためのルート切替自動化

1. はじめに

Direct Connect冗長構成では、メンテナンスに伴うフェイルオーバーにより、一時的な通信断が生じる可能性があります。わずかな通信断でさえも許容できない環境では、Direct Connectメンテナンス前後にBGPメトリック調整によるスイッチオーバー・スイッチバック (以降、ルート切り替え・切り戻し) が有効ですが、毎回手作業で実施する場合は稼働面や品質面で課題が残ります。

そこで、Direct Connectメンテナンスの計画イベントをトリガーとして、ルート切り替え・切り戻しを自動化する仕組みを検討・実装しました。本記事では、Direct Connectメンテナンスの課題に始まり、自動化アーキテクチャの全体像や実装・検証ポイント、今後の課題や展望を紹介します。2026年10月時点の情報に基づいており、最新情報は公式情報をご確認ください。

2. Direct Connectメンテナンスの課題

Direct Connect冗長構成でメインルートがメンテナンス対象となった場合は、メインルートからバックアップルートへのフェイルオーバーにより通信を継続できます。一方、切断検知やルート再計算により一定の時間を要するため、一時的な通信断が生じる可能性があります。

BGPやBFDのタイマー調整により切断検知を早めることで、通信影響を抑えることは可能です。ただ、通信断自体が無くなるわけではないため、システムによっては許容できないケースもあります。また、キャリア・インターコネクトサービスの仕様や構成によりBFDを利用できないケースもあります。

手作業によるルート切り替え・切り戻しはメンテナンスが計画されたルートを避けることで、通信影響をほぼ無くすことが可能です。しかし、メンテナンスが発生するたび作業要員をアサインし、作業品質を管理するなどのオーバーヘッドが課題です。

アプローチ 期待効果 残課題                  
BGP・BFDのタイマー調整 通信断時間を短縮可能 ・ 切断自体を許容できないシステムあり
・ BFDを利用できないサービス・構成あり
手作業による
ルート切り替え・切り戻し
通信断時間をほぼ無くせる ・ 作業要員をアサインする必要あり
・ 作業品質を管理する必要あり

3. ネットワーク構成と接続冗長化

前述の課題を踏まえたルート切り替え・切り戻しの自動化の仕組みを説明する前に、まずはその土台となるネットワーク構成について紹介します。

ハイブリッドネットワークのオンプレミス環境はAWS上で疑似オンプレミスとして構築し、キャリア・インターコネクトサービスはNTT DOCOMO BUSINESS社のFlexible InterConnect (以降、FIC) を利用しています。

FICはJapan EastとJapan Westで冗長化させ、Japan Eastをメインルート、Japan Westをバックアップルートとして利用します。メインルートとバックアップルートの優先順位付けは各FIC ConnectionのAS-Path Prependによって制御しています。

4. 自動化アーキテクチャとルート切り替え方式

本記事の主題であるルート切り替え・切り戻しを自動化する仕組みについて紹介します。サービスごとの詳細な動作は次のセクション以降で記載します。

  • AWS Healthから通知されるDirect ConnectメンテナンスをEventBridge Ruleで検知します。EventBridge RuleからLambdaにイベントを連携し、LambdaがEventBridge Schedulerにルート切り替え・切り戻しのスケジュールを登録します。

  • EventBridge Schedulerがスケジュールに基づいてStep Functionsを起動し、ルート切り替え・切り戻しに必要な一連の処理を制御します。Step FunctionsがLambdaを呼び出し、LambdaがFIC APIを実行します。

  • FIC APIにより、AWS-A/B~FIC Router (Japan East) のFIC Connection (以降、Japan EastのFIC Connection) のAS-Path Prepend (Egress) を変更します。これにより、ルート切り替え・切り戻しを実現します。

なお、本方式では既存ルートが維持された状態でルートが再計算されるため、通信断を伴わずにルート切り替え・切り戻しが可能です。

タイミング Japan EastのFIC Connection
AS-Path Prepend (Egress)
Japan WestのFIC Connection
AS-Path Prepend (Egress)
選択ルート
通常時 OFF 2 Japan East
ルート切り替え後 4 2 Japan West
ルート切り戻し後 OFF 2 Japan East

4.1 EventBridgeによる検知・登録

AWS Healthは、Direct Connectメンテナンス情報をイベント通知します。イベント種別は計画・延長・中止・完了などがあり、この自動化ではAWS_DIRECTCONNECT_MAINTENANCE_SCHEDULED の計画イベントをトリガーとして、ルート切り替え・切り戻しの実行タイミングを決定しています。

主なイベント 説明                       
AWS_DIRECTCONNECT_MAINTENANCE_SCHEDULED Direct Connectメンテナンスの計画イベント
AWS_DIRECTCONNECT_MAINTENANCE_EXTENSION Direct Connectメンテナンスの延長イベント
AWS_DIRECTCONNECT_MAINTENANCE_CANCELLED Direct Connectメンテナンスの中止イベント
AWS_DIRECTCONNECT_MAINTENANCE_COMPLETE Direct Connectメンテナンスの完了イベント


本来、ルート切り戻しは完了イベントを起点として実行するのが望ましいですが、この自動化は計画・完了イベントの関連付けが実装できていません。そのため、計画イベントに模したテストイベントに startTime と endTime を設定し、ルート切り替え・切り戻しの実行タイミングを決定しています。

主なフィールド 説明
service Direct Connectイベントを判定 (DIRECTCONNECT)
eventTypeCode 計画イベントを判定 (AWS_DIRECTCONNECT_MAINTENANCE_SCHEDULED)
eventScopeCode アカウント固有イベントを判定 (ACCOUNT_SPECIFIC)
startTime ルート切り替えの実行時刻を決定
endTime ルート切り戻しの実行時刻を決定
resources/affectedEntities Direct Connect接続/仮想インタフェースIDが一致するか判定
eventArn 同一イベントの重複管理防止に利用
lastUpdatedTime 同一イベントの最新通知判定に利用


EventBridge Ruleは、AWS Healthからのイベント通知を受け付けます。 イベントに含まれる source、eventTypeCode、eventScopeCode とEvent Patternを照合し、一致した場合にはLambdaへ連携します。

Lambdaは、環境変数のDirect Connect接続/仮想インタフェースIDと resources/affectedEntities を照合し、一致した場合にはEventBridge Schedulerにルート切り替え・切り戻しのスケジュールを登録します。 ルート切り替えは startTime の15分前に、ルート切り戻しは endTime に開始するように設定します。 ルート切り替えを startTime に開始しないのは、ルート切り替えが完了する前にメンテナンスが開始する可能性を避けるためです。

その他、同一イベントを複数受信した場合にスケジュールが重複しないよう eventArn を用います。 また、予定時刻が変更された場合に最新通知であることを確認し、スケジュールが更新できるよう lastUpdatedTime を用います。

4.2 Step Functionsによるフロー制御

EventBridge Schedulerは、スケジュールに基づいてStep Functionsを起動します。Step Functionsは、ルート切り替え・切り戻しに必要な一連の処理を制御します。 ルート切り替え・切り戻しでは共通のState MachineとLambdaを用いており、モードやアクションなどのパラメータを使い分けることで処理の共通化と構成の簡素化を図っています。

FIC APIによる設定変更は非同期で処理されるため、5秒間隔で処理状況の確認を繰り返し、Processing から Completed へ遷移してから設定反映の確認を行います。 また、FIC API仕様により同一FIC Routerの設定変更が同時実行できないため、Japan EastのFIC Connectionの設定変更は並列ではなく直列で実行しています。

アクション 説明                                     
precheck 全FIC Connectionの処理状況/設定を確認し、事前状態が期待通りか判定
patch Japan EastのFIC Connectionの設定変更を実行
get_operation Japan EastのFIC Connectionの処理状況を確認
verify Japan EastのFIC Connectionの設定反映を確認
postcheck 全FIC Connectionの処理状況/設定を確認し、事後状態が期待通りか判定

4.3 FIC APIによるルート制御

Step FunctionsからLambdaを呼び出し、LambdaがFIC APIを実行します。FIC APIにより、Japan EastのFIC Connectionの設定変更・状態確認を行います。以下の仕組みを利用することで、Step Functionsによるフロー制御を実現します。

Japan EastのFIC ConnectionのAS-Path Prepend (Egress) を変更する場合、PATCH /v2/router-to-aws-private-connections/{id} リクエストでパラメータを設定します。ルート切り替えでは out が 4、ルート切り戻しでは out が OFF (FIC APIではnull) となります。

{
  "connection": {
    "source": {
      "primary": {
        "asPathPrepend": {
          "in": null,
          "out": 4
        }
      }
    }
  }
}

リクエストを受け取った後、レスポンスとして 202 Accepted と合わせて operationId が取得できます。以降、GET /v1/operations/{id} リクエストで operationId を指定することで、対象となる設定変更を特定し、その処理状況を確実に確認できます。

{
  "connection": {
    "id": "Fxxxxxxxxxxxx",
    "operationStatus": "Processing",
    "operationId": "xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx",
    ...
  }
}

5. 自動ルート切り替え・切り戻しの検証

検討・構築した自動化の仕組みに対して、ルート切り替え・切り戻しを検証しました。 各サービスの状態確認、E2E通信の疎通性確認やルート確認を実施しました。 実際のDirect Connectメンテナンスの計画イベントでなく、疑似的なテストイベントをインプットにしています。

5.1 EventBridge確認

EventBridge Schedulerで登録されたスケジュールが期待通りであることを確認しました。

  • 上段:ルート切り替えが以下の通りであること
    • スケジュール名が dxmaint-switchover-* であること
    • ステータスが 有効 であること
    • スケジュールが Mon, Oct 19, 2026, 00:00:00 (UTC+09:00) であること
  • 下段:ルート切り戻しが以下の通りであること
    • スケジュール名が dxmaint-switchback-* であること
    • ステータスが 有効 であること
    • スケジュールが Mon, Oct 19, 2026, 04:00:00 (UTC+09:00) であること

5.2 Step Functions確認

Step Functionsの実行ステータス、グラフ、モードが期待通りであることを確認しました。

  • 上段:ルート切り替えが以下の通りであること
    • 実行ステータスが 成功 であること
    • グラフが期待ルートであること
    • モードが switchover であること
  • 下段:ルート切り戻しが以下の通りであること
    • 実行ステータスが 成功 であること
    • グラフが期待ルートであること
    • モードが switchback であること

5.3 FIC Connection確認

Japan EastのFIC ConnectionのAS-Path Prepend (Egress) が期待通りであることを確認しました。

  • 上段:ルート切り替えが以下の通りであること
    • コネクション名が dxmaint-conn-east-a、dxmaint-conn-east-b であること
    • AS-Path Prepend Egressが 4、4 であること
  • 下段:ルート切り戻しが以下の通りであること
    • コネクション名が dxmaint-conn-east-a、dxmaint-conn-east-b であること
    • AS-Path Prepend Egressが off、off であること

5.4 疎通性確認 (ping)

切り替え・切り戻し中に双方向でpingを実行し、通信断の有無を確認しました。

  • 上段:ルート切り替えが以下の通りであること
    • パケットロス率が 0% であること
    • RTTがルート変更に応じて段階的に変化しつつ、通信を継続できていること
  • 下段:ルート切り戻しが以下の通りであること
    • パケットロス率が 0% であること
    • RTTがルート変更に応じて段階的に変化しつつ、通信を継続できていること

※ ルートがAWS(東京)→FIC(東京)→AWS(東京)→FIC(東京)→AWS(東京)で約6ms、
  AWS(東京)→FIC(大阪)→AWS(東京)→FIC(東京)→AWS(東京)で約11ms、
  AWS(東京)→FIC(大阪)→AWS(東京)→FIC(大阪)→AWS(東京)で約16msでした

5.5 ルート確認 (traceroute)

切り替え・切り戻し前後でtracerouteを実行し、ルートの変化を確認しました。

  • 上段:ルート切り替え後が以下の通りであること
    • ホップアドレスが 172.16.1.5、172.16.1.6、172.16.2.5、172.16.2.6 であること
  • 下段:ルート切り戻し後が以下の通りであること
    • ホップアドレスが 172.16.1.1、172.16.1.2、172.16.2.1、172.16.2.2 であること
[ec2-user@ip-10-1-1-4 ~]$ traceroute 10.2.1.4
traceroute to 10.2.1.4 (10.2.1.4), 30 hops max, 60 byte packets
 1  ip-172-16-1-6.ap-northeast-1.compute.internal (172.16.1.6)  24.845 ms  7.758 ms  24.764 ms
 2  ip-172-16-1-5.ap-northeast-1.compute.internal (172.16.1.5)   8.217 ms  8.205 ms   8.194 ms
 3  ip-172-16-2-6.ap-northeast-1.compute.internal (172.16.2.6)   9.059 ms 25.326 ms   8.942 ms
 4  ip-10-2-1-4.ap-northeast-1.compute.internal (10.2.1.4)      16.213 ms 16.399 ms  16.290 ms

[ec2-user@ip-10-2-1-4 ~]$ traceroute 10.1.1.4
traceroute to 10.1.1.4 (10.1.1.4), 30 hops max, 60 byte packets
 1  ip-172-16-2-6.ap-northeast-1.compute.internal (172.16.2.6)   7.830 ms  7.717 ms  7.694 ms
 2  ip-172-16-2-5.ap-northeast-1.compute.internal (172.16.2.5)   8.299 ms  8.284 ms  8.296 ms
 3  ip-172-16-1-6.ap-northeast-1.compute.internal (172.16.1.6)   9.063 ms  9.050 ms  9.012 ms
 4  ip-10-1-1-4.ap-northeast-1.compute.internal (10.1.1.4)      16.273 ms 16.259 ms 16.444 ms
[ec2-user@ip-10-1-1-4 ~]$ traceroute 10.2.1.4
traceroute to 10.2.1.4 (10.2.1.4), 30 hops max, 60 byte packets
 1  ip-172-16-1-2.ap-northeast-1.compute.internal (172.16.1.2)  2.685 ms  2.778 ms  2.702 ms
 2  ip-172-16-1-1.ap-northeast-1.compute.internal (172.16.1.1)  3.547 ms  3.457 ms  3.218 ms
 3  ip-172-16-2-2.ap-northeast-1.compute.internal (172.16.2.2)  4.306 ms  4.367 ms  4.277 ms
 4  ip-10-2-1-4.ap-northeast-1.compute.internal (10.2.1.4)      6.346 ms  6.474 ms  6.398 ms

[ec2-user@ip-10-2-1-4 ~]$ traceroute 10.1.1.4
traceroute to 10.1.1.4 (10.1.1.4), 30 hops max, 60 byte packets
 1  ip-172-16-2-2.ap-northeast-1.compute.internal (172.16.2.2)  3.192 ms  3.138 ms  3.155 ms
 2  ip-172-16-2-1.ap-northeast-1.compute.internal (172.16.2.1)  3.909 ms  3.867 ms  3.887 ms
 3  ip-172-16-1-2.ap-northeast-1.compute.internal (172.16.1.2)  4.142 ms  4.094 ms  4.527 ms
 4  ip-10-1-1-4.ap-northeast-1.compute.internal (10.1.1.4)      7.345 ms  6.856 ms  7.317 ms


全ての検証結果が期待通りで、ルート切り替え・切り戻しが正常に完了することを確認できました。

6. 残課題と対処方針

ルート切り替え・切り戻しを自動化する仕組みを検討・実装・検証し、その有効性も確認できました。一方、実際の運用を想定した場合に、いくつかの課題が残っています。

残課題 対処方針
完了・延長・中止・緊急イベントに未対応 各イベントに応じたスケジュール処理を実装
イベント間の関連付けに未対応 各イベントが同一メンテナンスだと判別する方法を検討
実メンテナンスでの動作未確認 実メンテナンスでルート切り替え・切り戻しを確認

今後、実際のAWS Healthイベントで確認し、完了・延長・中止・緊急イベントへの対応を進めることで、より実運用に適した仕組みに発展できるのではないかと思います。

7. まとめ

本記事では、AWS Direct Connectメンテナンスに伴う通信断回避のため、ルート切り替え・切り戻しを自動化する仕組みを検討・実装・検証しました。

  • EventBridgeによるイベント検知・スケジュール登録、Step Functionsによるフロー制御、FIC APIによるルート制御を組み合わせ、ルート切り替え・切り戻しの自動化を検討・実装しました。

  • ルート切り替え・切り戻しが正常に完了すること、その途中でパケットロスが発生せずに、通信が継続できることを検証し、すべてが期待通りであることを確認しました。

  • 今後は実際のAWS Healthイベントでの確認や、完了・延長・中止・緊急イベントへの対応により、より実運用に適した仕組みへ発展できる可能性が考えられます。

Direct Connectメンテナンスに関して同様の課題を持つ方がおられたら、本記事でご紹介した自動化の仕組みが参考になれば幸いです。

Site-to-Site VPN over Direct Connectのプライベート接続でハマった落とし穴3選

はじめに

近年、セキュリティ要件が高まっており、「通信経路の暗号化」が必須となるケースが増えています。ただ、アプリケーションレイヤでの暗号化が難しい場合には、ネットワークレイヤでの暗号化が必要となってきます。さらに、ハイブリッドネットワークのDirect Connet接続構成においては、MAC暗号化は10G以上の接続が必要なため、Site-to-Site VPN over Direct Connectのプライベート接続が候補になります。

本記事では、Site-to-Site VPN over Direct Connectのプライベート接続の導入・運用でハマった事例を紹介します。対象者としてDirect ConnectやSite-to-Site VPNの基本的な仕組みや導入・運用経験はあるものの、Site-to-Site VPN over Direct Connectのプライベート接続は経験がない、といった方に実際の経験で得られた教訓を共有します。本記事の内容は2026年4月時点の情報に基づいており、最新の仕様や機能については公式情報をご確認下さい。

ネットワーク概要

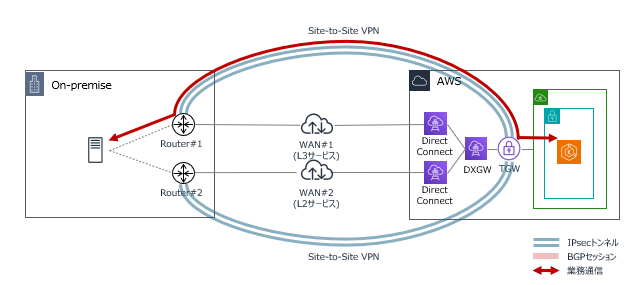
本記事では、オンプレミスとAWSがWANサービスで接続されたハイブリッドネットワークをベースに見ていきます。構成や条件の概要は以下に示し、落とし穴の各項目で関連するパラメータ詳細を示しています。

環境 説明
オンプレミス
  • ルータはCISCO製で二重化
  • ルータ間はiBGP、WAN向けはeBGP、LAN向けはスタティックルート
WAN
  • 網は異なるキャリアで二重化
  • 主系網はL3サービスでBGP接続、副系網はL2サービスで直接接続
AWS
  • リソースはTGW + DXGW + DX + Site-to-Site VPN
  • DXはSite-to-Site VPNピアアドレスをルーティングするために利用

落とし穴①:ルーティング設計誤りによる意図しないルート選択

事象
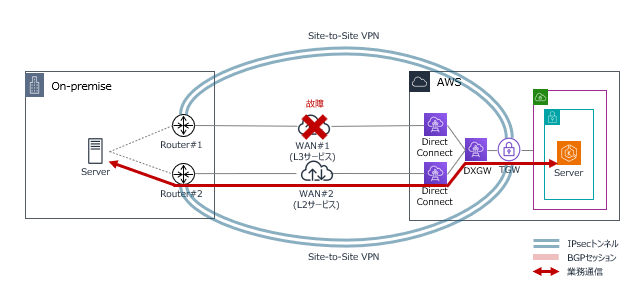
運用中のハイブリッドネットワークにおいて、暗号化要件のある業務通信を流すことになりました。Transit Gatewayは既存リソースを流用し、Site-to-Site VPNとCustomer Gatewayは新規リソースを作成したところ、エンドツーエンドの通信は問題なく成功しました。ただ、肝心のルートを確認した結果、主系ルートが故障した場合に副系ルートのみSite-to-Site-VPNでなくDirectConnect経由のままになっており、暗号化要件を満たしていない状態になっていました。
原因
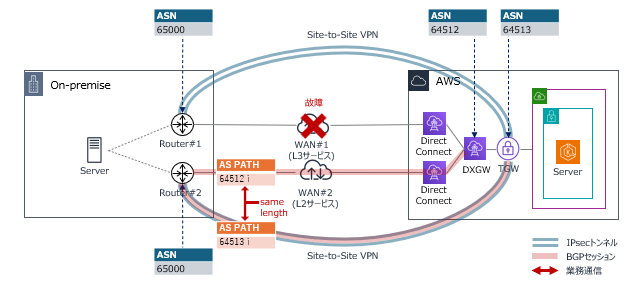
Direct ConnectとSite-to-Site VPN経由のBGP属性/条件の違いにより、意図しないルートを選択したためでした。オンプレミスルータで明示的にルート制御を行っていなかったため、主にはAS_PATHおよびoldest pathによりルートが決定されていました。
AS_PATH
Direct Connet経由ではL2サービス利用時はDXGWのみ、L3サービス利用時はDXGWとWANのAS番号が追加されます。一方、Site-to-Site VPNではL2/L3サービスを問わずに、Transite GatewayのAS番号のみが追加されます。

そのため、L3サービスを利用していた主系ルートはDirect Connect経由のAS_PATHが長くなり、Site-to-Site VPN経由のルートが選択されました。一方、L2サービスを利用していた副系ルートはDirect ConncetとSite-to-Site VPN経由のAS_PATHが等しいため、この時点ではルートがまだ決定されませんでした。

Direct Connet経由でL2サービス利用時は、DXGWだけではなくTransit GatewayのAS番号も追加されるのでは?と思った方もいるのではないでしょうか。こちらは、DXGWがAS PATH OverrideしているかのようにDXGWのAS番号のみ連携する仕様のためです。
aws.amazon.com
oldest path
L2サービス利用時などのAS_PATH長が等しい場合、安定性を優先するため既存ルートを維持する動作により、結果として先に接続していたルートが選択される場合があります。

そのため、L2サービスを利用していた副系ルートは後から接続したSite-to-Site VPN経由でなく、先に接続していたDirect Connect経由のルートが選択される結果となりました。

ただし、oldest pathはRFC 4271で定義されておらず、ベンダ実装へ依存します。あくまで安定性を優先する仕様と捉え、より手堅いBGP属性/条件でルート制御することが重要です。
datatracker.ietf.org
対処
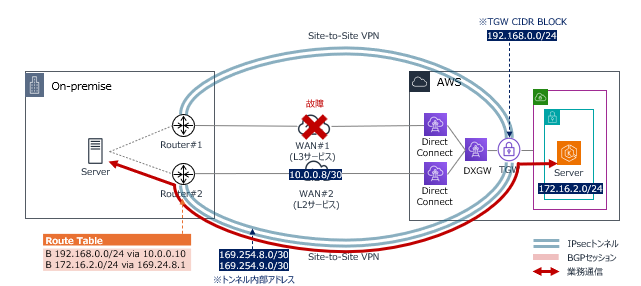
事象と原因だけ見れば、DirectConnectよりSite-to-Site VPN経由の方が優先されるようにメトリック調整することで解決します。しかし、以下の理由により、DirectConnect経由はVPNトンネルのピアアドレスのみ、Site-to-Site VPN経由は業務通信アドレスのみ許可するルート制限を行いました。
  • ルーティング設計をシンプルにすることで維持の負担を軽減するため
  • VPNトンネルが故障した場合、暗号化されていない通信が流れる可能性があるため
  • 不要な通信が流れること自体がセキュリティ上よろしくないため

Direct ConnectとSite-to-Site VPNを併用する場合、BGPのデフォルト動作だけでは意図したルートが選択されるとは限りません。BGPメトリック調整のほかルート制限などを用いることで、暗号化要件を確実に満たす設計とすることが重要です。

落とし穴②:アドレス設計誤りによるVPN切断

事象
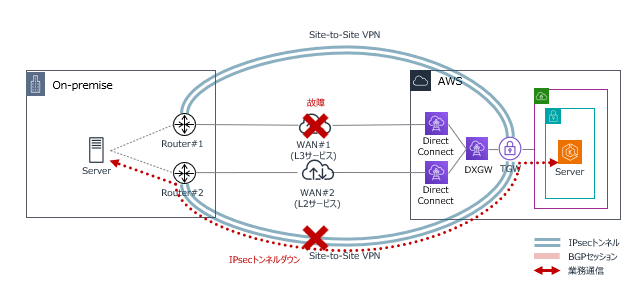
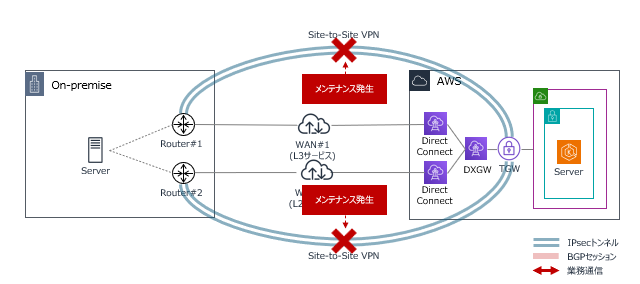
ハイブリッドネットワークの主系ルート故障試験で、オンプレミスルータのWAN抜線やTunnel閉塞で疑似故障を再現し、副系ルートに問題なくフェイルオーバーすることを確認していました。ところが、主系ルートのDirect ConnectでBGPフェイルオーバーテスト機能を実行してみると、副系ルートにフェイルオーバーするものの、Site-to-Site VPNのIPsecトンネルがダウンしていました。その他の確認できた内容は、以下の通りです。
  • 主系ルートが復旧すると、副系ルートも復旧する
  • 試験を3回実施し、事象が3回とも発生しているため再現性あり
  • Direct ConnectのBGPセッションは、アップしたまま
  • キャプチャデータを見る限り、AWSからオンプレミスへのパケットが届いていない
  • その他、設定・ログ・ステータスは異常なし
原因
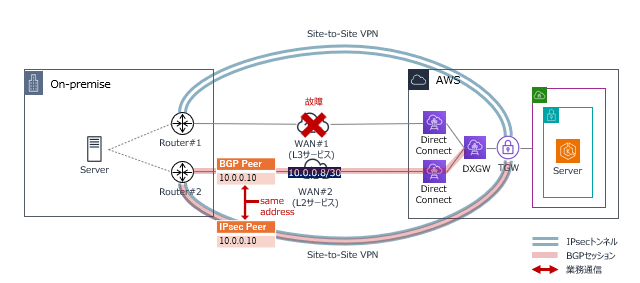
Direct ConnectのBGPピアとSite-to-Site VPNのIPsecピアの両方ともに同一アドレスを利用していたためでした。オンプレミスネットワークでは不要なアドレス割り当てを避けるため常套手段でしたが、AWSネットワークでは不具合が生じる仕様のようでした。

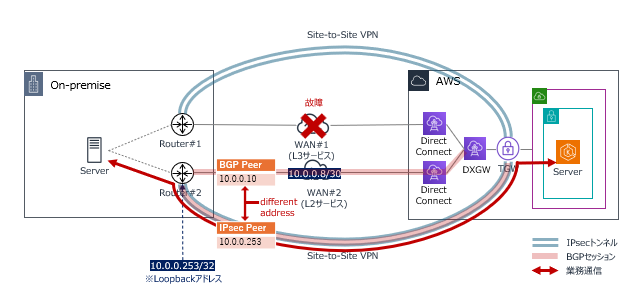
AWSドキュメントでは、Direct ConnectのBGPピアはpoint-to-pointのアドレスを、Site-to-Site VPNのIPsecピアはオンプレミスルータのLoopbackまたはLANインタフェースのアドレスを使用することが推奨されています。
docs.aws.amazon.com
対処
AWSドキュメントに記載の通り、Site-to-Site VPNのIPsecピアをオンプレミスルータのWANからLoopbackインタフェースへ変更し、事象が解消することを確認できました。変更で必要な設定作業は、以下の通りです。
  • オンプレミスルータにて、Loopbackインタフェースを作成
  • オンプレミスルータにて、IPsecトンネルのローカルアドレスをLoopbackアドレスに変更
  • オンプレミスルータにて、Direct ConnectにLoopbackアドレスをアドバタイズするように変更
  • オンプレミスルータにて、ACLでLoopbackアドレスを許可するように変更
  • AWS Customer Gatewayにて、WANからLoopbackのアドレスに変更

オンプレミスネットワークで通用してもAWSネットワークで通用しないことは多々あります。AWSはサービス進化が速いことから、導入実績があってもプロジェクト導入直前にドキュメントを改めて見直すことは重要かと思います。

落とし穴③:頻繁なメンテナンスによるSNMP Trap多発

事象
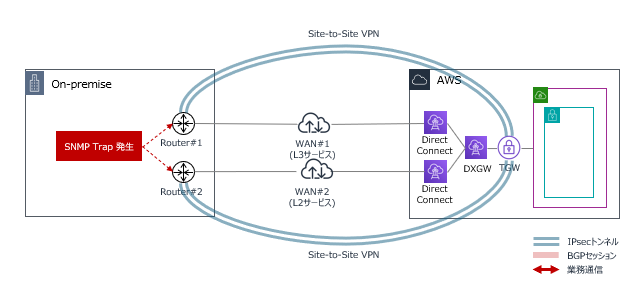
ハイブリッドネットワークの運用開始直後から、1~2ヶ月あたり1度、また1度あたり数回の頻度でIPsecトンネル/BGPセッションダウンのSNMP Trapメッセージが発生していました。一方、これらのメッセージに関連し、業務通信に影響することはありませんでした。
原因
SNMP Trap多発の原因は、Site-to-Site VPNのメンテナンスでした。時期や環境による差もありますが、Site-to-Site VPNはDirect Connectと比べてメンテナンス頻度が高い傾向があります。

AWS側ではSite-to-Site VPNのライフサイクル制御機能やHealth Dashboardのイベント通知機能などでメンテナンスと判別できますが、オンプレミス側ではルータログなどでメンテナンスと故障が判別できません。そのため、オンプレミスルータからの不要なSNMP trapによる運用業務への影響が課題となりました。

ちなみに、何故SNMP Trapが発生しているにも関わらず、業務通信には影響しないのでしょうか。理由は、Site-to-Site VPNのメンテナンス開始直前にAWSがメトリックを調整し、メンテナンス開始予定のトンネルから冗長化されたもう一方トンネルに業務通信がフェイルオーバーされるためです。詳しい動作については、以下の記事をご覧ください。
yamamototis1105.hatenablog.com
対処
オンプレミス側とAWS側のそれぞれで対処方針を検討しました。
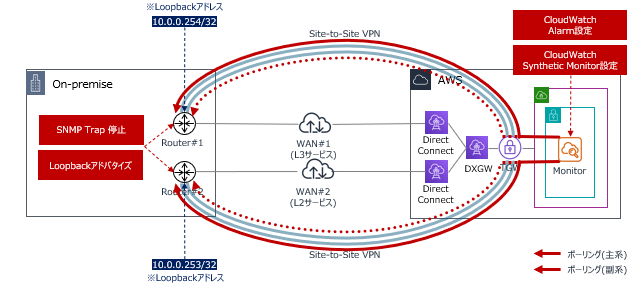
まず、オンプレミス側はルータログなどでメンテナンスと故障が判別できないため、IPsecトンネルおよびBGPセッションダウンに関するSNMP Trapを停止することとしました。一方、SNMP Trapを停止するだけでは故障で発報できなくなります。そこで、AWS側はメンテナンス時を除いて故障時のみ発報する仕組みを検討・実装しました。

AWS側での実装方法の一つとして、CloudWatch Synthetic Monitorを用いてオンプレミスルータのLoopbackアドレスへポーリングし、遅延もしくはパケット損失率が閾値を超過した場合に発報する方法が挙げられます。この方法を実装するうえで、重要なポイントは以下の通りです。
  1. ポーリングがIPsecトンネルのフェイルオーバーに追従できるよう、Loopbackアドレスはオンプレミスルータから冗長化された両方のIPsecトンネルへアドバタイズすること。
  2. IPsecトンネルの単一故障では発報しないため、Site-to-Site VPNのTunnelState(トンネル接続状態)メトリクスも別途監視し、一定時間ダウンした場合に発報すること。
Site-to-Site VPNのメンテナンスによるダウンタイムは1~2分のため、一例としては1分間隔・5回連続でダウンした場合などのCloudWatch Alarm条件が考えられます。

CloudWatch Synthetic Monitorは、ハイブリッドネットワークの通信品質を管理するうえでも有効なサービスです。例えば、遅延やパケット損失率が上昇するようなグレー障害に対して大きな力を発揮します。CloudWatch Synthetic Monitorについては、以下の記事をご覧下さい。
yamamototis1105.hatenablog.com

Site-to-Site VPNではメンテナンスが頻繁に実施されるため、オンプレミス側のSNMP Trapだけでは不要なアラームを避けられません。AWS側の監視サービスを活用することにより、メンテナンス時に発報させず、故障時のみ発報させる監視設計を行うことが重要です。

まとめ

本記事では、Site-to-Site VPN over Direct Connectのプライベート接続の導入・運用でハマった事例、そこから得られた教訓を紹介しました。

これからSite-to-Site VPN over Direct Connectを導入・運用する方にとって、本記事が参考になりますと幸いです。

AWS Interconnectによるマルチクラウド接続

はじめに

 2025年11月30日にAWS Interconnect - multicloud(以下、Interconnectと記載)のプレビューが発表されました。高速かつ安定性の高い閉域接続により、AWSとその他のクラウド間を接続するサービスです。

 ベンダロックインやBest-of-Breedなどの考え方を背景にしてマルチクラウド接続が注目される中で、本記事では実際にInterconnectを検証した結果とともに、今後のマルチクラウド接続を考察します。

 マルチクラウド環境におけるネットワーク接続の方式にお悩みをお持ちの方や、Interconnectによるマルチクラウド接続にご興味をお持ちの方は是非ご覧ください。

マルチクラウド接続の構成パターン

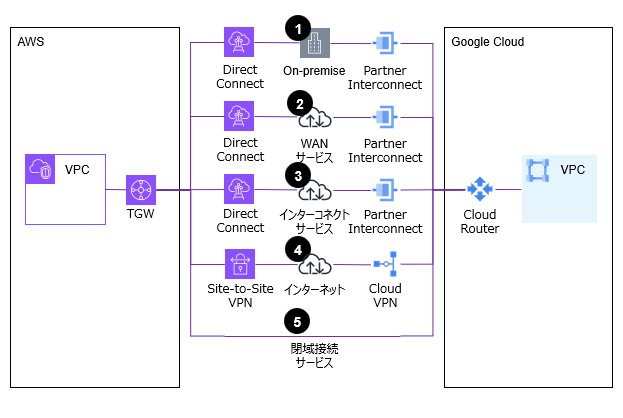
 Interconnectを理解する前提として、そもそもマルチクラウド接続はどのような構成があるかご存じでしょうか。ここではAWSとGoogle Cloudの閉域接続時における構成例を挙げ、一般的なマルチクラウド接続構成とその特徴を整理します。

➊オンプレミス拠点経由
  • AWSとGoogle Cloudハイブリッドネットワークをオンプレミスで接続する構成です。
  • オンプレミスがボトルネックとなりやすいです。
➋WANサービス
  • 通信キャリアが提供するWANサービスを介し、AWSとGoogle Cloudを接続する構成です。
  • 高速かつ安定性が高く、今までのネットワークを活用できるため導入しやすいです。
➌インターコネクトサービス
  • DC事業者が提供するDCサービスを介し、AWSとGoogle Cloudを接続する構成です。
  • 高速かつ安定性が高く、単なる接続だけでなく機能が豊富であることが多いです。
➍インターネットVPN
  • AWSとGoogle Cloudをインターネット経由で接続する構成です。
  • コストは安価で抑えられますが、その他構成と比べると通信品質が劣ります。
➎閉域接続サービス
  • クラウド事業者が提供する閉域接続サービスでAWSとGoogle Cloudを接続する構成です。
  • 高速かつ安定性が高く、直接接続されるため構成が最適化されています。


 本記事で取り扱っているInterconnectは、閉域接続サービスに該当します。上記のような特徴を備えつつもサービスが少なかったこともあり、注目を浴びています。

AWS Interconnectとは

 Interconnectは、高速かつ安定性が高く、AWSとその他のクラウド間を接続します。マネージドサービスにより構築・運用の負荷が軽減され、またオープンな仕様によりネットワーク相互運用性を高められることから、今後も多くのクラウド接続が進むことが期待されます。

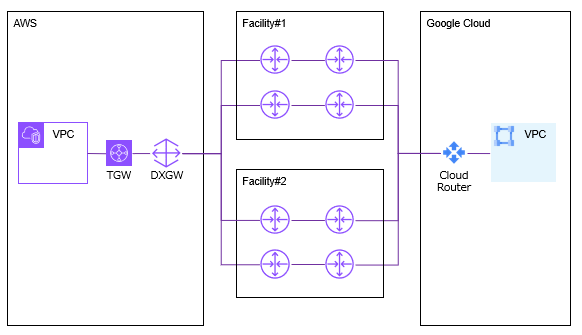
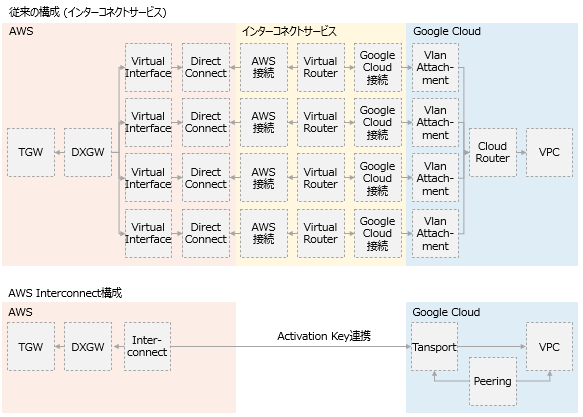
 構成は、AWS・Google Cloudとも物理構成を公開していますが、手順等から想定される論理構成を追記しました。今までの方式では接続(AWSはVIFなど・Google CloudはVlan Attachmentなど)を多重度に応じて作成する必要がありました。しかし、この方式ではAWSでInterconnectを作成のうえアクティベーションキーを作成し、GoogleCloudでアクティベーションキーを設定のうえTransport・Peeringを作成するだけでよく、構成が簡素化されたことは明らかです。

 AWSへ接続されるリソースはDirect Connect Gatewayですが、アタッチメントとしてInterconnectのほかPrivate VIFやTransit VIFを追加、ゲートウェイとしてVGW、TGW、CloudWANを関連付けることが可能です。

 AWSとGoogle Cloudのリージョン対応状況は、以下の通りです。

AWS Google Cloud
米国東部(北バージニア) us-east-1 北バージニア(us-east4)
米国西部(北カリフォルニア) us-west-1 ロサンゼルス (us-west2)
米国西部(オレゴン) us-west-2 オレゴン (us-west1)
ヨーロッパ(ロンドン) eu-west-2 ロンドン(europe-west2)
Europe (フランクフルト) eu-central-1 フランクフルト (europe-west3)
➊運用性
 CloudWatchで帯域利用率のメトリクス、SyntheticMonitorで遅延とパケット損失率のメトリクスをモニタリングし、アラームで検知可能です。ただし、ネットワークヘルスインジケータは未対応で、ヘルス状態が確認できないためご注意下さい。
➋セキュリティ
 AWSとその他のクラウドの暗号化は、デフォルトでエッジデバイス間のMACsec暗号化が行われます。Direct Connectでは10G以上しか利用できませんが、Interconnectのプレビューでは1Gで利用できるようです。GAでも1Gで利用できるよう期待したいですね。
➌信頼性
 AWSとその他のクラウドの冗長化は、デフォルトでファシリティ・デバイスが二重化、ルートが四重化されます。Direct Connectでは最大限の回復性となる、重要な本番ワークロード向けのマルチサイト冗長デプロイ構成と同等です。
➍パフォーマンス
 帯域はプレビュー時に1Gですが、GA時に最大100Gまで拡張する予定です。その他の性能関連のパラメータとしては、受信可能なプレフィクスはIPv4・IPv6とも1000個、MTUサイズは8500byteとなります。
➎コスト
 プレビュー時は1Gが無料利用できます。GA時における時間あたりの料金や通信料あたりの料金は発表待ちとなります。

AWS Interconnect検証

 InterconnectでAWSとGoogle Cloud間を接続する検証を実施しました。AWS・Google Cloudの手順は以下を参照しております。

docs.aws.amazon.com docs.cloud.google.com
Interconnect作成 (AWS)

 Interconnect作成を参照したい場合、こちらをご覧下さい。
  1. AWSマネジメントコンソール上で、「Direct Connect」画面で「AWS Interconnect」メニューを選択し、「マルチクラウド相互接続を作成」を押下
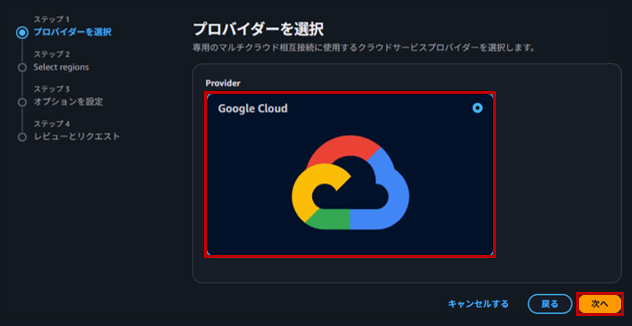
  2. 「プロバイダーを選択」画面で以下の項目を入力し、「次へ」を押下
    • Providerは、「Google Cloud」を選択
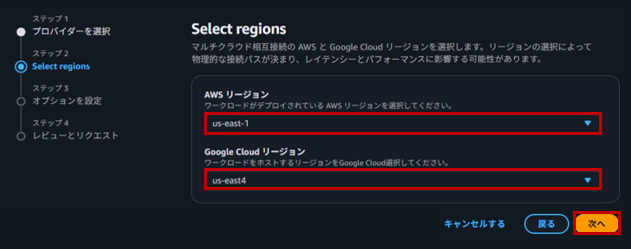
  3. 「Select Regions」画面で以下の項目を入力し、「次へ」を押下
    • AWSリージョンは、「us-east-1」を選択
    • Google Cloudリージョンは、「us-east4」を選択
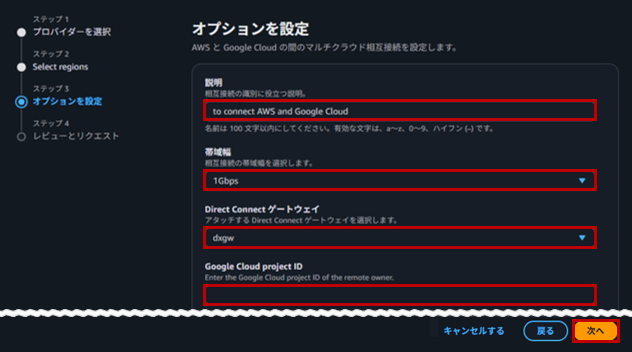
  4. 「オプションを選択」画面で以下の項目を入力し、「次へ」を押下
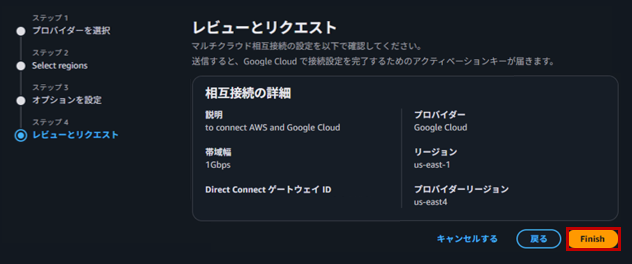
  5. 「レビューとリクエスト」画面で「Finish」を押下
  6. 「マルチクラウド相互接続が正常にリクエストされました」というメッセージを確認し、「アクティベーションキーをコピー」を押下

Transport・Peering作成 (Google Cloud)

 Transport・Peering作成を参照したい場合、こちらをご覧下さい。
  1. Google Cloudマネジメントコンソール上で、CloudShellを起動
    ※ NetworkConnectivityのAPIが有効化されていない場合、あらかじめ有効化しておくこと
    gcloud services enable networkconnectivity.googleapis.com
  2. トランスポート(AWS~Google Cloudの接続)を以下のパラメータで作成
    エラーコードが出力されていないことを確認
    ※ dataオプションのjsonフォーマットが誤っている場合、400コードがレスポンスされる
    ※ URLのプロジェクト名が誤っている場合、403コードがレスポンスされる
    • プロジェクト名は、「(作成済みのプロジェクト名)」を入力
    • トランスポートIDは、「(任意テキスト)」を入力
    • bansdwidthは、「BPS_1G」を入力
    • networkは、「(Google CloudのVPC名)」を入力
    • advertisedRoutesは、「(Google CloudのSubnetアドレス)」を入力
    • providedActivationKeyは、「(取得済みのアクティベーションキー)」を入力
    • stackTypeは、「IPV4_ONLY」を入力
      ※ 2025年12月30日時点で公式ドキュメントは、「"」が抜けていたため要注意
    curl \
    -H "Authorization: Bearer $(gcloud auth print-access-token)" \
    -H "Content-Type: application/json" \
    https://networkconnectivity.googleapis.com/v1beta/projects/project-name/\
    locations/us-east4/transports?transportId=transport \
    --data '
    {
    "bandwidth": "BPS_1G",
    "network": "vpc",
    "advertisedRoutes": ["10.1.0.0/16"],
    "providedActivationKey": "xxxxxxxxxxxxxxx",
    "stackType": "IPV4_ONLY"
    }'
  3. トランスポートに紐付いたピアネットワークを以下のコマンドで確認
    ※ 状態は数分~数十分でCREATING→PENDINGCONFIGへ遷移し、
     Direct Connect Gateway~ゲートウェイ接続でPENDINGCONFIG→ACTIVEへ遷移する
    ※ 状態がPENDINGCONFIGもしくはACTIVEの場合のみ、
     ピアネットワークはpeeringNetworkとして出力されるため控えること
    gcloud beta network-connectivity transports describe transport --region=us-east4
  4. ピアリング(ピアネットワーク~ユーザが作ったVPCの接続)を以下のパラメータで作成
    ピアリング状態がACITIVEであることを確認
    ※ ピアネットワーク名が誤っている場合、ピアリング状態がINACTIVEとなる
     BGPセッションを確立するが、ルートを送信できるものの受信できない
    • トランスポートIDは、「(任意テキスト)」を入力
    • networkは、「(Google CloudのVPC名)」を入力
    • peer-networkは、「(ピアネットワーク名)」を入力
    • stackTypeは、「IPV4_ONLY」を入力
      ※ 2025年12月30日時点で公式ドキュメントは、「\」が抜けていたため要注意
    gcloud compute networks peerings create "transport" \
        --network="vpc" \
        --peer-network="xxxxxxxxxxxxxxx" \
        --stack-type="IPV4_ONLY" \
        --import-custom-routes \
        --export-custom-routes

接続確認

 接続確認を参照したい場合、こちらをご覧下さい。
  1. AWSマネジメントコンソール上で、「VPC」画面で「TGWルートテーブル」メニューを選択し、対象ルートテーブルを選択。AWSの持つ10.0.0.0/16だけでなく、Google Cloudの持つ10.1.0.0/16を学習していることを確認
  2. Google Cloudマネジメントコンソール上で、「VPCネットワーク」画面で「ルート」メニューを選択し、対象ネットワーク・リージョンを選択。Google Cloudの持つ10.1.0.0/16だけでなく、AWSの持つ10.0.0.0/16を学習していることを確認

Transport・Peering削除(Google Cloud)

 Transport・Peering削除を参照したい場合、こちらをご覧下さい。
  1. ピアリングを以下のパラメータで削除
    ピアリング数が0であることを確認
    • トランスポートIDは、「(任意テキスト)」を入力
    • networkは、「(Google CloudのVPC名)」を入力
    gcloud compute networks peerings delete transport \
      --network=vpc
    gcloud compute networks peerings list --network=vpc
    
  2. トランスポートを以下のパラメータで削除
    トランスポートリストが一つも表示されないことを確認
    • トランスポートIDは、「(任意テキスト)」を入力
    gcloud beta network-connectivity transports delete transport \
      --region=us-east4
    gcloud beta network-connectivity transports list --region=us-east4
    

Interconnect削除(AWS)

 Interconnect削除を参照したい場合、こちらをご覧下さい。
  1. Interconnectは、Transport・Peering削除時点で合わせて削除されるため対応不要

今後のマルチクラウド接続

 Interconnectはマネージドサービスにより構築・運用の負荷が軽減され、またオープンな仕様によりネットワーク相互運用性を高められることから、今後はクラウド・サービス間の直接接続はより一般的になってきます。

 一方で、接続のハードルが下がることにより、要件ごとにアドホック(行き当たりばったり)な接続を繰り返した結果、複雑な構成に陥るリスクも高まります。マルチクラウド環境ではただ単に接続できるだけでなく、全体構成を意識した設計が重要になります。

 そのため、AWSやGoogle Cloudなどに接続ポイントを集約し、無秩序なフルメッシュ構成を避けるための設計ポリシーを持つことがポイントです。こうした設計上のポイントを踏まえて、以下のような利用シーンが今後拡がっていくと考えられます。

DRやバックアップ
 単一クラウドにおける冗長化に加えて、クラウド障害や運用ミスなどの広域リスクに備える手段として、異なるクラウドを活用した DR/バックアップ構成の検討が進むと考えられます。
クラウド・サービスごとの役割分担
 AWSは運用基盤、Google Cloudはデータ分析基盤として活用するなど、クラウドの特徴や自社の環境を踏まえた役割分担により、より最適化された構成が選択できると考えられます。

まとめ

 本記事では、AWS Interconnectの概要および検証結果、さらにはマルチクラウド接続の構成パターンや今後についてご紹介しました。Interconnect導入をご検討される方がいらっしゃいましたら、本記事を参考にして頂けると幸いです。

AWS VPCネットワークにおける暗号化を再考する ― Nitro Systemと暗号化制御 ―

はじめに

 2025年11月21日にAWS VPCネットワークの暗号化制御が公表されました。「物理層やNitro Systemで暗号化されているのでは?」「新しい暗号化機能?」と思った方もいらっしゃるかもしれませんが、どのような機能でしょうか。

 本記事では、AWS VPCネットワークにおける暗号化ニーズ、暗号化サービス、暗号化制御、暗号化検証および結果の流れでご紹介します。セキュリティへの関心が高まる中、本機能導入をご検討される際などに是非ご覧下さい。

aws.amazon.com

暗号化ニーズ

 金融業界を初めとして、 これまで主に拠点間ネットワークに対する暗号化が求められてきました。一方、最近ではオンプレミス環境におけるLANネットワーク、クラウド環境におけるVPCネットワークに対して暗号化を求められるケースも見受けられています。

 背景としては、ゼロトラストの考え方が広まり、「閉域ネットワーク=安全」が成り立たないことがあります。例えば「NIST SP 800-53 / SC-8 TRANSMISSION CONFIDENTIALITY AND INTEGRITY(通信の機密性および完全性)」は改訂されていないものの、内部/外部ネットワークを問わずという考えのもとで、スコープや解釈が拡大しているケースなどが見られます。

 このような状況下においては、暗号化機能をクラウドマネージドサービスへオフロードすることが、運用負荷を抑える有効な手段になります。さらに、各サービスが有する機能を正しく理解しておくことで、効率的なサービス導入が可能になります。

暗号化サービス

 VPCネットワークにおける暗号化方法として、物理暗号化およびNitro Systemによる暗号化をご紹介します。クラウドマネージドサービスへオフロードする考え方に基づき、ユーザがデバイスやトンネルを構成するSite-to-Site VPNやClient VPNは対象外としています。

物理暗号化
 リージョン間やAZ間のバックボーンネットワークでは、物理層(レイヤ1)の暗号化が実施されています(同AZ内の暗号化は明記されていません)。トラフィックに対して透過的に行われるため、ユーザが設定/制御するものではありません。[1] [2]

[1] AWS Prescriptive Guidance - General Encryption Best Practices
"All data transmitted between AWS Regions over the AWS global network is automatically encrypted by AWS at the physical layer"
docs.aws.amazon.com

[2] Encrypting Data at Rest and In Transit - Logical Separation on AWS
"All network traffic between AWS data centers is transparently encrypted at the physical layer. "
docs.aws.amazon.com
Nitro Systemによる暗号化
 同リージョン内のNitro Systemが搭載されたインスタンス間では、ネットワーク層(レイヤ3)の暗号化が実施されています。こちらもトラフィックに対して透過的に行われるため、ユーザが設定/制御するものではありません。[3]

[3] Amazon Elastic Compute Cloud - Data protection in Amazon EC2
"To support this additional in-transit traffic encryption between instances, the following requirements must be met:
  • The instances use the following instance types:
    • General purpose: M5dn, M5n, M5zn, M6a, M6i, M6id, M6idn, M6in, M7a, M7g, M7gd, M7i, M7i-flex, M8a, M8g, M8gb, M8gd, M8gn, M8i, M8i-flex, Mac-m4, Mac-m4pro
    • Compute optimized: C5n, C6a, C6gn, C6i, C6id, C6in, C7a, C7g, C7gd, C7gn, C7i, C7i-flex, C8a, C8g, C8gb, C8gd, C8gn, C8i, C8i-flex
    • Memory optimized: R5dn, R5n, R6a, R6i, R6id, R6idn, R6in, R7a, R7g, R7gd, R7i, R7iz, R8a, R8g, R8gb, R8gd, R8gn, R8i, R8i-flex, U-3tb1, U-6tb1, U-9tb1, U-12tb1, U-18tb1, U-24tb1, U7i-6tb, U7i-8tb, U7i-12tb, U7in-16tb, U7in-24tb, U7in-32tb, U7inh-32tb, X2idn, X2iedn, X2iezn, X8g, X8aedz
    • Storage optimized: D3, D3en, I3en, I4g, I4i, I7i, I7ie, I8g, I8ge, Im4gn, Is4gen
    • Accelerated computing: DL1, DL2q, F2, G4ad, G4dn, G5, G6, G6e, G6f, Gr6, Gr6f, Inf1, Inf2, P3dn, P4d, P4de, P5, P5e, P5en, P6-B200, P6-B300, P6e-GB200, Trn1, Trn1n, Trn2, Trn2u, VT1
    • High-performance computing: Hpc6a, Hpc6id, Hpc7a, Hpc7g
  • The instances are in the same Region.
  • The instances are in the same VPC or peered VPCs, and the traffic does not pass through a virtual network device or service, such as a load balancer or a transit gateway."
docs.aws.amazon.com

 Nitro Systemによる暗号化は、様々な条件に基づき実施されています。トラフィックの暗号化状態を可視化し、暗号化されたトラフィックのみ流れる状態を実現するうえで、今回リリースしたAWS VPCネットワークの暗号化制御が有効です。

暗号化制御

 VPCネットワークの暗号化制御は、MonitorモードとEnforceモードが選択できます。MonitorモードはVPCフローログで暗号化状態を確認できるようにします。EnforceモードはNitro Systemによる暗号化をサポートしてないリソースの作成やアタッチを禁止します。

docs.aws.amazon.com


 以上の内容を踏まえ、暗号化制御のEnforceモードは以下のような理解が適切かと思います。

  • 「トラフィックを直接暗号化する機能ではない」
  • 「Nitro Systemにより暗号化されていないトラフィックが成立しないように制御する」
  • 「結果として、暗号化されたトラフィックのみ流れる状態を実現する」
暗号化制御を作成したい場合、以下の手順をご参照下さい。
  • 新規VPCで作成する場合、「VPCを作成」画面で以下を入力し、「VPCを作成」を押下
    • 暗号化モードは、「なし」「モニタリングモード」「強制モード」から一つだけ選択
    • 除外リソースは、「IGW」「Egress-only IGW」「NATGW」「VGW」「Lambda」「VPC Peering」「VPC Lattice」「EFS」から一つ以上選択
  • 既存VPCで作成する場合、「お使いのVPC」画面で「VPC暗号化コントロール」を選択し、「暗号化コントールを作成」を押下
  • 「暗号化コントロールを作成」画面で以下を入力し、「暗号化コントロールを作成」を押下
    • 名前は、任意のリソース名称を入力
    • VPCは、暗号化制御を作成したいVPCを選択
    • モードは、「モニタリングモード」「強制モード」から一つだけ選択
  • 暗号化制御を作成したら、「VPC暗号化コントロール」画面で状態が「使用可能」であることを確認

暗号化検証および結果

 今までご紹介した機能を確認するために、暗号化状態の可視化、暗号化をサポートしてないリソースの作成失敗について検証を実施しました。

暗号化状態の可視化
 暗号化制御がMonitorモードで動作する中、暗号化されていない通信と暗号化された通信を流し、VPCフローログで可視化できることを検証しました。
  1. Nitro対応~Nitro非対応インスタンス間でicmp送信
  2. Nitro対応インスタンス間でicmp送信
 VPCフローログの1枚目がNitro対応~Nitro非対応インスタンス間で暗号化されておらず、2枚目がNitro対応インスタンス間で暗号化されていることを確認しました。
 9番目のフィールドが「encryption-status」であり、「0」は暗号化されておらず、「1」は暗号化されていることを意味します。


暗号化をサポートしてないリソースの作成失敗
 暗号化制御がEnforceモードで動作する中、Nitro非対応インスタンスを作成しようとしたら、失敗することを検証しました。
  1. Nitro非対応インスタンスを作成
 「インスタンスを起動」画面でエラーメッセージが表示され、インスタンスが作成されないことを確認しました。


まとめ

 本記事では、AWS VPCネットワークにおける暗号化ニーズ、暗号化サービス、暗号化制御、暗号化検証および結果の流れでご紹介しました。
 今後、VPCネットワークにおける暗号化制御を利用される方がいらっしゃいましたら、本記事を参考にして頂けると幸いです。

Amazon Q CLIでシューティングゲームを作ってみた

はじめに / Introduction

 Amazon Q Developer CLIを用いてゲームを作成したら、Tシャツを貰えるイベントがあったのでチャレンジしてみました。本記事では、Amazon Q Developer CLIでゲームの計画から実装までご説明し、簡単に誰でも作れることをご紹介します。

 ※ ゲームと言っても簡単なミニゲームレベルですのでご注意下さい。

community.aws

ゲームアイデアの発想 / Game Concept

 一番初めに思い付いたのは、自機がオンプレミスサーバーから飛び立って、敵を倒しながら、ハイブリッドネットワークやゲートウェイを超えて、エンドポイントを目指す誰得な横スクロール型のシューティングゲームでした。

 ネットワークの変人玄人な皆様がよく言われる「パケットの気持ちになって...」を具現化したゲームですね。ただ、自身がAIもコーディングもポンコツのため、今回はシンプルな横スクロール型のシューティングゲーム作成を目標にしました。

開発環境の準備 / Environment Setup

 自分の環境はWindowsでしたので、下記のサイトを参考にしつつ、Amazon Q Developerのほか、WSLやPythonなどのソフトウェアをインストールしました。環境の違いによって必要な準備も異なるため、参考程度に留めて下さい。

community.aws
  1. WSL(Ubuntu)をインストールし、再起動
    wsl --install
  2. WSL上でunzip、pip、venvをインストール
    sudo apt update
    sudo apt install -y unzip curl python3-pip python3-venv
  3. WSL上でAmazon Q Developerをインストール ※ついでに認証やログインも実施される
    curl -# -o q.zip "https://desktop-release.q.us-east-1.amazonaws.com/latest/q-x86_64-linux.zip"
    unzip -o q.zip
    chmod +x q/install.sh
    ./q/install.sh
    echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
    source ~/.bashrc
  4. Windows上でpygameをインストール
    pip install pygame
  5. WSL上でq chat実行
    q chat

開発の流れ / Development Flow

 基本的には、チャットに要件を入力し、Amazon Q CLIが実装し、Pythonでテストする、という流れの繰り返しです。以下はチャットに要件を入力している画面ですが、環境の違いによって実際の画面と異なる可能性もありますのでご留意下さい。

ザコステージの実装 / Enemy Stage

 横スクロール型のシューティングゲームの簡単な仕様を入力しただけで、以下のような遊べるものができました。雑な要件だけで形を成すところがスゴすぎる...  

 ザコは、移動も弾も直進する三角形と、移動はジグザグで弾は全方向発射する六角形へ変更。三角形は編隊組ませたが、縦1列と横1列の認識齟齬があり、2~3ターンのやりとり消費汗。  

ボスステージの実装 / Boss Stage

 ボスは、ザコを何体かやっつけると出現し、弾を何体か当てると撃破。ただ見た目はデフォルトだと単なる四角形で威厳も無く...  

 マザーシップっぽい造形、ビットからの弾幕、定期的な回転式のレーザービーム。弾の速度や角度、インターバルなどの細かい注文へお付き合い頂きました笑  

画面構成 / Screens

 いきなりゲームが開始したり終了したりとゲームらしくなかったので、タイトル画面、ゲームオーバー画面やゲームクリア画面などを差し込んでもらいました。  

 文字とボタンで味気なかったため、SFっぽいカッコよくしてほしいとお願いしたら、Galactic Warというサブタイトルまで勝手に付けてくれました。  

 我ながらバランス良いかも?ただ自分はシューティングゲームが下手なので、無敵モードをすぐさま実装しましたが、、、汗

所感とまとめ / Reflection and Takeaways

 Amazon Q CLIは、「ノーコードでゲームが出来上がる」体験が衝撃的でした。今後もユースケースや最新動向はぜひウォッチしていきたいと思いました。

  • 開発者でなくプレイヤーとして好き勝手言うだけでゲームが出来上がる。
  • 要件理解やソースコード変更で時々間違えるが、自発的にテストしたり修正したりとかなり賢い。
  • コードを書くことより仕様を考えることに集中したい場合に強力なツールになる。

GitHubリポジトリ / GitHub Repository

 Amazon Q CLIで作成したシューティングゲームのソースコードおよびREADMEは、GitHubへアップロードしてます。ご興味を持たれた方はそちらを是非ご確認下さい。

github.com

AWS VPC Route Server vs TGW Connect Attachment 非機能観点で比べてみた

はじめに

 2025/04/01にVPC Route ServerがGAされ、仮想アプライアンスのHA構成として新しい選択肢が増えました。類似サービスのTGW Connect Attachmentと比べ、どのような違いがあるのでしょうか。

 本記事では、VPC Route ServerとTGW Connect Attachmentの非機能観点で比べてみた結果をご紹介します。他もこんな違いがあるよというのがあれば教えていただけると幸いです。

aws.amazon.com

仮想アプライアンスの課題

 本記事でご紹介する仮想アプライアンスは、VPC上でEC2インスタンスとしてデプロイし、オンプレミス向けのトラフィックをインスペクションするような構成を前提にしています。具体的には、SD-WANアプライアンスなどをイメージしていただければと思います。

 VPC上でEC2インスタンスとしてデプロイした仮想アプライアンスは、ユーザ側で冗長化のうえフェイルオーバーの仕組みを実装する必要があります。この仕組みを実装する方式として、冒頭に述べたVPC Route ServerやTGW Connect Attachmentを用いた方式があります。


 ちなみに、仮想アプライアンスのHA方式は、以下の記事で取り上げていますので是非ご覧下さい。

yamamototis1105.hatenablog.com

VPC Route Server/TGW Connect Attacmentとは

 VPC Route Serverは、仮想アプライアンスとBGPセッションを確立のうえルーティング情報を学習し、VPCルートテーブルへアドバタイズします。万が一、仮想アプライアンスの主系が故障した場合、副系からのルーティング情報に更新されてフェイルオーバーします。また、仮想アプライアンスの主系が復旧した場合、主系からのルーティング情報に更新されてフェイルバックします。


 TGW Connect Attachmentは、仮想アプライアンスとGREトンネル上でBGPセッションを確立のうえルーティング情報を相互に学習し、アドバタイズします。VPC Route Serverは、 トラフィックがGREカプセル化されずに流れますが、TGW Connect Attachmentは、トラフィックがGREカプセル化されたうえで流れる点が異なります。


 このような両サービスですが、次以降のセクションで非機能性の観点毎の違いをご紹介します。

パフォーマンス

 VPC Route Serverはスループット上限がありませんが、ルート上限が100で制限されています。一方で、TGW Connect Attachmentはスループット上限が5Gbpsで制限されていますが、ルート上限は1000まで利用可能です。ボトルネックになる可能性がありそうなクォータをピックアップしましたが、その他のクォータは以下のドキュメントをご参照下さい。

docs.aws.amazon.com
docs.aws.amazon.com

 TGW Connect AttachmentはトラフィックがGREカプセル化され、アドレスやポートが固定化されるため、Security Groupの接続追跡数が上限値に達する可能性はありません。一方で、VPC Route ServerはトラフィックがGREカプセル化されず、アドレスやポートは業務次第となるため、Security Groupの接続追跡数が上限値に達する可能性があります。Security Groupの接続追跡は、以下の記事をご参照下さい。

yamamototis1105.hatenablog.com

信頼性

 TGW Connect Attachment、VPC Route Serverは、BGPセッションのエンドポイントやピアが冗長化されている点が共通していますが、BFD対応の差でTGW Connect AttachmentよりVPC Route Serverの方がフェイルオーバー時間を短縮可能です。

 TGW Connect Attachmentは運用実績に基づき、メンテナンス影響は瞬断レベルで抑えられることが確認できています。一方で、VPC Route Serverはリリースから間も無く運用実績も少ないため、具体的な影響が確認できていません。TGW Connect Attachmentのメンテナンス影響は、以下の記事をご参照下さい。

yamamototis1105.hatenablog.com

セキュリティ

 TGW Connect Attachmentは、トラフィックがGREカプセル化されているため、Security GroupやNACLを用いてもアドレスやポートでアクセス制御ができません。一方で、VPC Route Serverは、トラフィックがGREカプセル化されていないため、Security GroupやNACLを用いればアドレスやポートでアクセス制御可能です。


運用性

 TGW Connect Attachmentは、BGPセクションのエンドポイントやピアのほか、GREトンネルのパラメータなどの管理が必要となり負荷が高くなります。一方で、VPC Route Serverは、BGPセクションのエンドポイントやピアのみの管理で済むため負荷が抑えられます。

 TGW Connect Attachmentは、Network Managerに登録しておくことでBGPイベントログを確認できます。一方で、VPC Route Serverは、メインルートだけでなくバックアップルートもBGPメトリックを確認できるなど、それぞれに優位性を持っています。

 TGW Connect AttachmentはGREカプセル化されているため、トラブルシューティング等の際に仮想アプライアンスがデプロイされたVPC上でVPCフローログを取得しても分析できず、TGW上で取得・分析する必要があります。

 VPC Route ServerはSNS統合されており、Cloud Watchアラームを利用せずにメッセージを連携するなども可能です。例えば、エンドポイントがメンテナンス状態となった場合、運用担当者にメールを送信するなども可能です。

コスト

 TGW Connect Attachmentは、Attachmentごとの接続料金およびデータ処理料金がかかりますが、VPC Route Serverは、Endpointごとの接続料金がかかります。VPC Route Serverは高レートのため、ご利用の際はその他要件とのトレードオフを考慮のうえご利用下さい。

aws.amazon.com
aws.amazon.com

まとめ

 本記事では、AWS VPC Route ServerとTGW Connect Attachmentの非機能観点で比べてみた結果をご紹介しました。新規サービスのVPC Route Serverの優位性が確認できたものの、コストが厳しいため現状はTGW Connect Attachmentが選択されるケースが多いのではないかという印象を受けました。

VPC Route Server TGW Connect Attachment
パフォーマンス
  • スループットのクォータは「制限なし」
  • ルート数のクォータは「100」
  • Security Groupの接続追跡は「確認必要」
など
  • スループットのクォータは「5Gbps」
  • ルート数のクォータは「1000」
  • Security Groupの接続追跡は「確認不要」
など
信頼性
  • エンドポイントは「冗長化」
  • ピアは「冗長化」
  • BFDは「対応」
  • メンテナンス影響は「不明」
など
  • エンドポイントは「冗長化」
  • ピアは「冗長化」
  • BFDは「非対応」
  • メンテナンス影響は「原則なし」
など
セキュリティ
  • Security Groupは「制御可」
  • NACLは「制御可」
など
  • Security Groupは「制御不可」
  • NACLは「制御不可」
など
運用性
  • 運用負荷は「シンプルな設計で小さい」
  • BGPメトリックは「確認可」
  • SNSメッセージは「通知可」
など
  • 運用負荷は「複雑な設計で大きい」
  • BGPイベントログは「確認可」
  • VPCフローログは「分析不可」
    ※仮想アプラアンスのENIにて
など
コスト
  • 接続料は「エンドポイントあたり1.03USD/h」※東京リージョン
など
  • 接続料は「アタッチメントあたり0.07USD/h」※東京リージョン
  • データ処理料は「0.02USD/GB」
など